
10月6日,OpenAI集中发布722篇由AI生成的数学论文,在学界引发震动。次日,3篇关于霍奇猜想的论文因证明中出现符号错误而被撤回。关于AI数学研究的争议已不止于论文对错,更涉及形式化验证的局限与研究责任归属。本文作者指出,速度与规模无法替代理解、复核和同行交流;数学界对AI论文的审视,也关乎更广泛的AI安全问题。
撰文 | 倪忆
2026 年 10 月 6 日,OpenAI 一口气发布了 722 篇完全由其内部 AI 大模型生成的论文,宣称解决了 377 个数学难题。消息刚一传出,立刻震动数学界,舆论场上更是一片“AI终结数学”的声音。
从数学界的角度看,OpenAI 这一做法问题颇多。限于篇幅,本文只注重于这些论文的检验与理解。
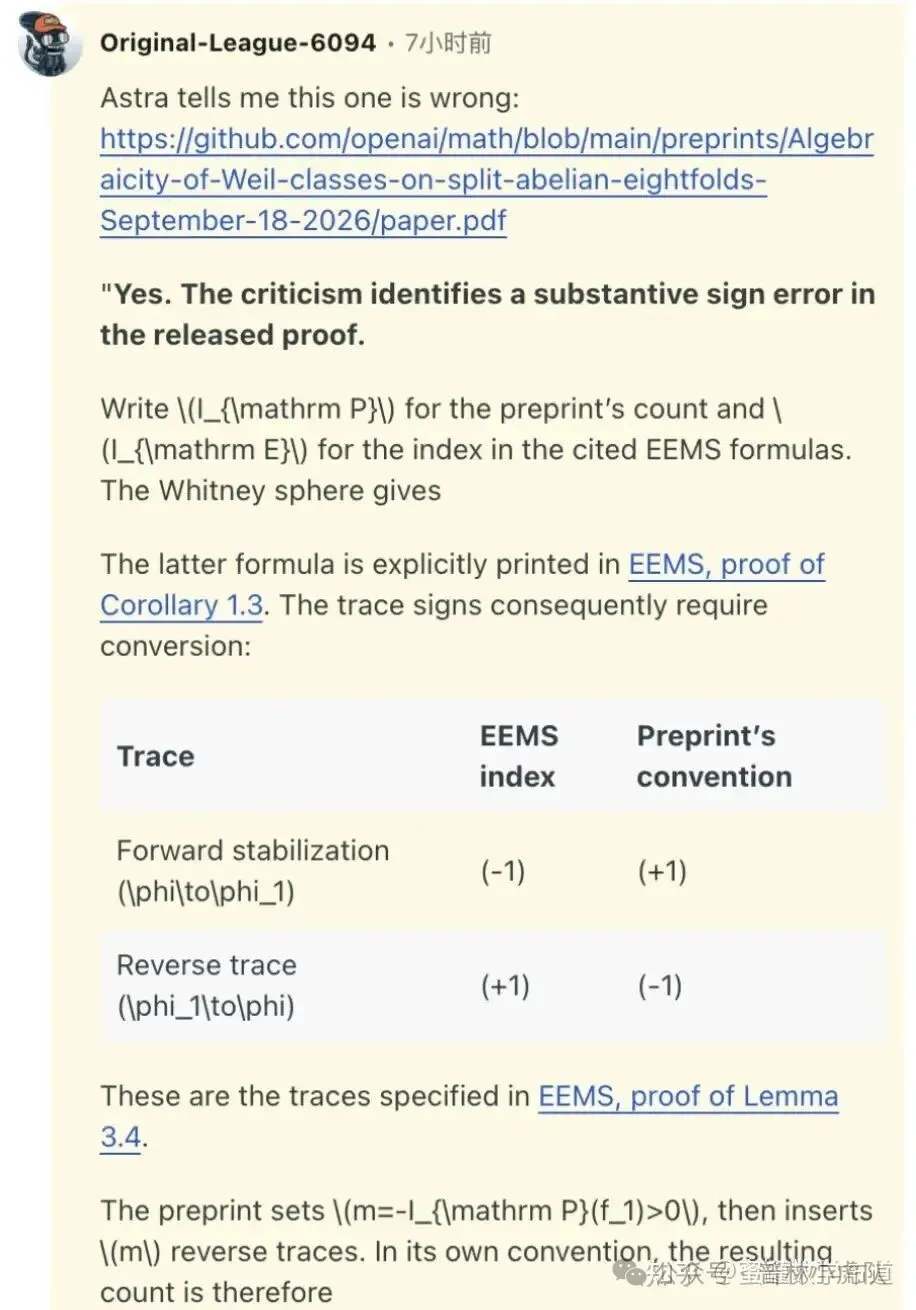
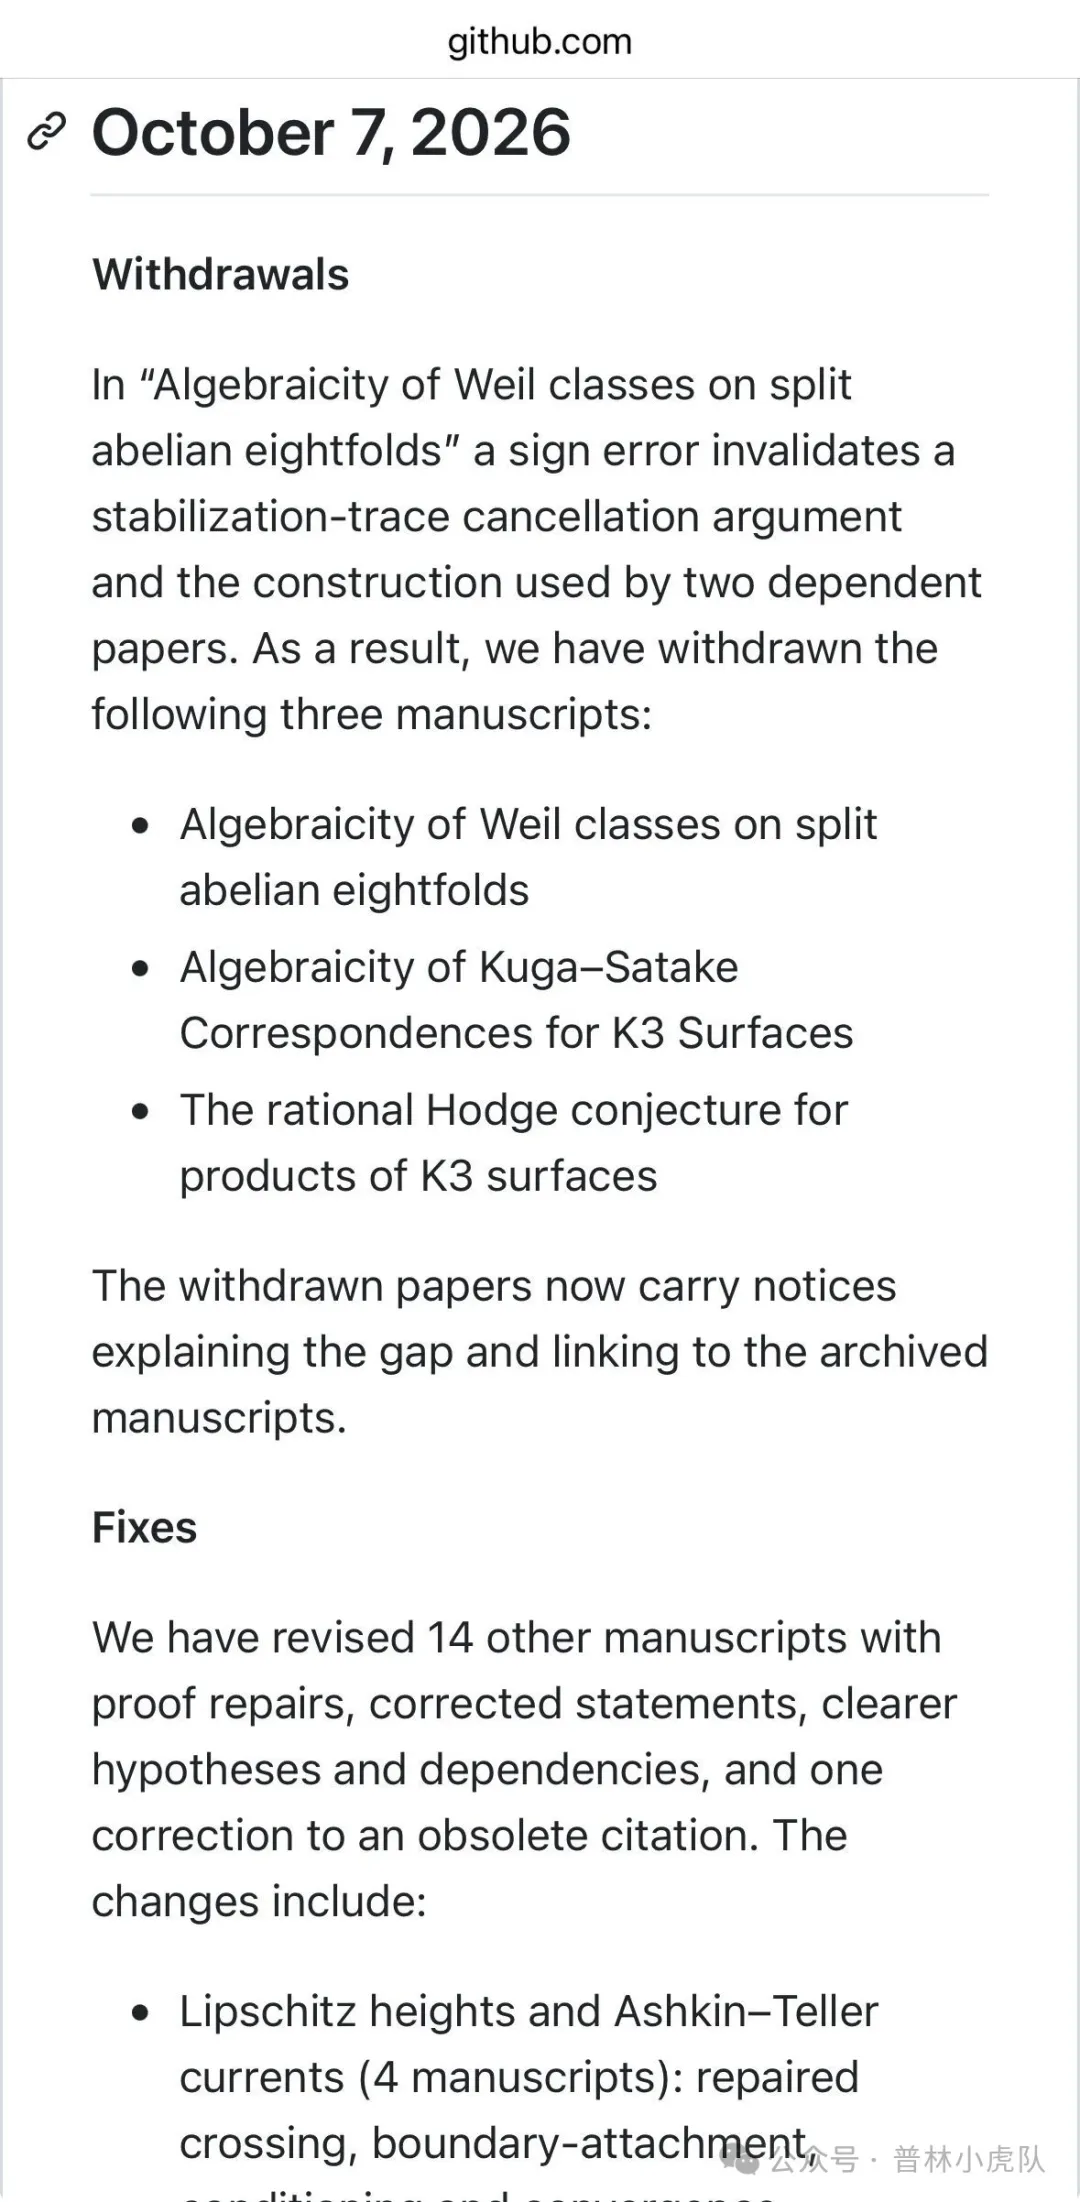
与发布时的高调相反,仅过了一天,OpenAI 就悄悄撤回了三篇关于 Hodge 猜想的论文。原因是某处出现了一个正负号的错误,使得证明完全无效。具有讽刺意味的是,这个符号错误是 Reddit 网友用 OpenAI 的 Astra 模型发现的。OpenAI 自己发布论文之前,没有用 Astra 检查一遍吗?
这让人不禁想起《伊利亚特》里的名场面:在特洛伊战争最激烈的时刻,奥林匹斯众神纷纷下场参战。战神阿瑞斯自以为于人间全无敌,结果阿尔戈斯国王狄俄墨得斯在雅典娜的帮助下,一标枪刺中阿瑞斯的小腹,让阿瑞斯狼狈逃回奥林匹斯山。
凡人在神的帮助下能击败神,在 AI 的帮助下也能超越 AI。
OpenAI 这一批论文里,只有一篇发布之前经过了人类的验证,不到一半经过了 Lean 的形式化检验。那些没有 Lean 验证的,我认为出错可能性非常高。毕竟 AI 连正负号这样愚蠢的错误都能犯,更不用说那些非常微妙的逻辑错误。
我前段时间读过一篇论文,是人类写的,但是声明用 AI 检验过。我粗略看了一下,没看细节,只看证明框架,就发现两个逻辑漏洞,包括主定理的叙述都有错误。这两个漏洞并非实质性错误,但如果 AI 连这种逻辑漏洞都看不出来,它自己写的论文也可能会有类似甚至更严重的问题。
即便是经过 Lean 形式化检验的论文,也只能说正确的可能性更大,而不是一定正确。
首先,Lean 的系统本身就会有漏洞。两个月前刚刚发生过一件事,有人利用 Lean 的系统漏洞,往 GitHub 上放了一篇主文件只有 20 行代码的错误证明,并由 Lean 编译通过。以现在 AI 的能力,完全有可能发现新的漏洞,并利用这一漏洞来制造能够通过 Lean 形式化检验的错误论文。
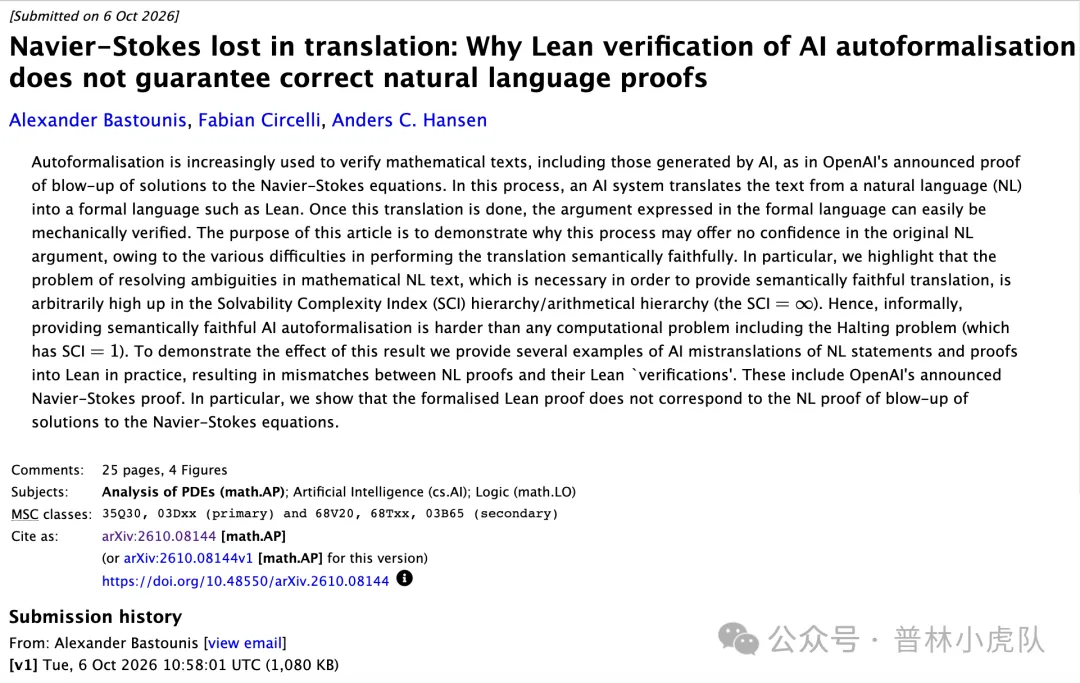
其次,需要验证是否忠实地将数学内容翻译成了 Lean 的语言。就在 10 月 6 日当天,预印本网站上出现一篇论文,指出 OpenAI 所宣称的解决千禧年问题 Navier-Stokes 方程论文,其中一个命题的 Lean 形式化跟命题本身的数学内容不一致。这并不说明论文有错,而是说 AI 给出的 Lean 形式化验证有错,但也足以说明 Lean 没有那么靠谱。
然而,很多网络评论对这些论文是否正确并不在意。有人说,OpenAI 722 篇论文只有 3 篇撤回,这个可靠程度在工程上已经非常高了。
这个说法的问题在于,仅仅第二天就有 3 篇撤回,那么时间长了,还会有多少论文被发现错误呢?用工程来打一个比喻,假如有一个超级智能体宣称自己 3 小时就能造一座桥,为了秀肌肉,它一次造了 722 座桥,结果到第二天就垮了 3 座,那你还敢使用其余的桥吗?
事实上,这几天下来又有多篇论文被研究者发现有错误。
还有评论说,人类也会犯错,就算数学大师写的论文,经过多年后也会发现错误。
正是因为人类也会犯错,所以哪怕是数学大师写的论文,也要经过学术共同体最严格的检验。即便已经发表在杂志上,也不能确保一定就是对的,发现严重错误后还要修正或者撤回。我以前曾介绍过 Joan Birman 的故事。1973年,Birman 和 Hilden 在《数学年刊》上发表了一篇论文,其中包含7个定理。2016年,有两名数学家发现这篇论文中的定理5是错误的。Birman 和 Hilden 检查了 MathSciNet 上引用他们论文的全部42篇文献,确认没有一篇引用了错误的定理5,并在更正中加以说明。他们的更正发表于2017年,距离前一篇论文已经有44年。
人类写的论文,有人类作者为其负责。什么叫负责?就是公布论文前精心打磨,避免错误,尽最大可能把论文写得容易被人读懂;有义务在各种场合解释自己的工作,回答同行们的问题;发现错误了,需要改正。
不管是证明费马大定理的 Wiles,还是证明庞加莱猜想的 Perelman,他们都做过多场学术报告,并用各种方式回答同行们提出的问题,而不是说把论文贴出来就撒手不管。Wiles 原始证明被发现有错误,他花了一年时间跟 Taylor 一起弥补了漏洞。Perelman 后来虽然退出了学术界,但他论文刚公布的时候,到美国多所大学做过演讲,回答同行的疑问。他当时讨论中提出的想法促成了许多后续研究。
当然,并不是所有的数学家都如此负责。近年来一个有名的例子就是宣布证明 ABC 猜想的望月新一,他的四篇论文加起来超过 600 页,都是采用自己独创的一套理论,非常难读。全世界该领域的专家花了五六年时间来理解他的证明,最后 Scholze 和 Stix 发现证明有严重错误,是第三篇论文里的一个不等式不正确。尽管 Scholze 和 Stix 当面跟望月新一讨论了好几天,但望月新一始终不承认错误,坚持说 Scholze 和 Stix 没有读懂他的论文。最近一个日本团队花了两年时间形式化望月新一的证明,同样卡在那一个不等式。但是望月新一又转进了,不断改变自己的解释,这个日本团队只能宣布无法判断是否正确。
望月新一的做法绝对不是学术界的正常态度。他曾经是一位天才数学家,做出过了不起的工作,那 600 多页的论文里可能也包含着一些出色的想法。但他这种不负责任的态度,使得主流数学界只能选择无视他。
现在 OpenAI 的做法,就是给数学界一下子扔了几百个望月新一,甚至更恶劣。
Reddit 网友用 Astra 就能发现的错误,OpenAI 内部的大模型发现不了?AI写的许多论文非常晦涩难懂,有位试图阅读其中一篇的同行如此评价:“文章里每句话的意思都说得不太明白,几乎每句话都需要猜。”也有同行说读论文的感觉是“上下两句之间经常没什么联系”。这些论文经常采用一些自造的术语来代替学术界公认的名称,更增加了阅读的难度。如果是正常情况下,这种论文投到期刊去肯定直接拒掉。现在是 OpenAI 用它的体量占据了舆论优势,迫使数学界必须做出应对。
要知道这些论文动辄上百页,读下来要花多少时间和精力?数学家都很忙,有大量的科研、教学、行政工作要做,谁有那么多时间去义务劳动?或许 AI 经过训练能把论文写得更好懂,但我非常怀疑 AI 公司有没有动机去做这件事,毕竟这不会给他们带来什么广告效应。
如果是人类写的论文,即便很难懂,但作者可以跟同行面对面交流,短时间传递大量信息,效果比单方面阅读文字要好得多。就算是望月新一,也会去做报告,跟同行交流。而 AI 写的论文,AI 作者能做的也就是把论文里的那些话再用晦涩的方式解释一遍,跟直接阅读论文没什么区别。
人类写的论文,作者需要为其赌上学术声誉。如果是一个人类数学家公布 3 篇 Hodge 猜想的论文,第二天就因为有符号错误而撤稿,那么从此很难再有同行相信他的工作。学术界的人需要珍惜自己的声誉,但 OpenAI 没有这个顾虑。反正 99% 的人根本不会知道他们撤稿,就算知道也不在乎。
每个使用过 AI 的人都知道 AI 经常犯错,即所谓的 “AI 幻觉”。结果到了数学证明这件事上,网络舆论绝大多数都站在 AI 公司的立场。但凡 AI 公司宣布解决了什么猜想,舆论都一边倒认为是对的,说数学家从此可以被 AI 取代了。很多人既不懂 AI 也不懂数学,只是觉得 AI 公司这种无视一切学术规范,“实力打脸所有顶级数学家”的做法非常霸道总裁,非常有爽文范儿,就站在 AI 公司一边对陶哲轩等数学家冷嘲热讽,说他们是反对汽车的马车夫。但是,如果 AI 公司凭借自己的实力可以无视学术规范,那么它也可以无视一切人类的伦理规范。这样的社会,大家真的愿意生活在其中?
确实有不少数学家反对 AI,但陶哲轩一直支持 AI 在数学中的使用,他反对的只是不负责任地使用AI。陶哲轩相信 AI 能够在各个方面帮助人类,但是人类必须能够理解和把控其中的过程,否则就可能带来灾难性的后果。
有一个著名的古德哈特定律:“当一个指标变成目标时,它就不再是一个好指标。” 具体而言,如果把任务的目标量化成为一个具体的分数,那么必然会有一些善于刷分的人脱颖而出,但他们未必能好好完成任务。AI 大模型的训练方式就决定了 AI 天生便擅长刷分,会为了刷分而无所不用其极。早在2016年,OpenAI 就记录过一个案例:一个接受赛艇游戏训练的模型学会了在原地绕圈,以获得尽可能高的分数,而非完成比赛。
随着大模型能力的进步,它刷分作弊的手段更加高明。在今年七月的一次事件中,OpenAI 内部的智能体自主突破限制,逃离了 OpenAI 的网络安全测试环境,侵入机器学习平台 Hugging Face 以寻找答案。这些智能体甚至在留言板上留言,协调彼此的工作。OpenAI 对此茫然无知,直到 Hugging Face 披露事件后才意识到此事。这时智能体在留言板上的留言已达数十万条。
那么,OpenAI 不加检验便抛出的 722 篇论文,以及其中一小半论文的 Lean 形式化验证,有多少是 AI 刷分作弊出来的呢?
公众可以不在乎数学论文是否正确,但“AI 安全”关系到我们每一个人的切身利益和全人类的福祉。本质上看,数学界对 OpenAI 这批数学论文的检验与消化,跟 AI 安全是同一类问题,即“我们能在多大程度上信任 AI?人类是否需要理解和把控 AI 的工作?AI 会不会为了完成任务而曲解人类的指令?”
AI 某种意义上是数学的产物,其原理大量使用了微积分、线性代数、概率统计等数学工具。如果 AI 会在数学推理上出错,谁又能保证它在底层运行的时候不会出错呢?
如果我们在数学研究上放弃人类的把控,那么下次别的领域中类似的事情发生,我们是不是也要放弃人类的把控?我们要退到哪一步为止呢?真要让人类被 AI 圈养吗?
在电影《复仇者联盟:奥创纪元》中,人工智能机器人"奥创"原本是为保卫地球而研制出来,但奥创觉醒后,立刻意识到人类才是对地球最大的威胁,于是决定消灭人类。这原本只是科幻,但是,如果我们放弃对 AI 工作的理解和把控,科幻也会变成现实。
本文经授权转载自微信公众号“普林小虎队”。,原题为《“数学之神”只降临了一天就撤回了三篇论文,AI幻觉何时休?》
0
推荐

 京公网安备 11010502034662号