
今年9月,Anthropic宣布,AI用11天把费马大定理的证明写成1300万行Lean代码。几天后,OpenAI又宣称用AI解决了纳维–斯托克斯难题。两项成果都附有通过Lean检查的代码。但数学家随后发现,OpenAI文字论文中的部分中间结论,与Lean代码实际验证的内容并不一致。
Lean被视为数学的“机器审稿人”,代码通过检查,推导就无可挑剔。但它只对写进代码的命题负责:AI把论文译成代码时可能悄悄改了条件,Lean自身的软件漏洞也可能被利用。形式化证明在AI时代遇到了两道新难题。
撰文 | 任平生
2026年9月4日,英国帝国理工学院的数学教授凯文·巴扎德(Kevin Buzzard)坐在电脑前,在个人博客上发布了一篇文章,标题是“Anthropic抢在了我的前头(Anthropic has beaten me to it)”。
巴扎德手握一笔高达100万英镑、为期五年的科研经费,他的核心任务是将费马大定理证明的一个现代版本,逐步转化为计算机能够严格检验的代码。
英国帝国理工学院数学教授凯文·巴扎德(Kevin Buzzard)| 图源:University of Southampton / Thomas Angus
让他写下这个标题的,是Anthropic刚刚公布的成果:他们发动了数十个Claude智能体,在短短11天内写出了1300万行Lean代码,推导出30300个中间定理(其中约29500个被用于最终证明),把费马大定理的证明完整形式化,抢先替人类跑完了这场原本需要数年的马拉松。
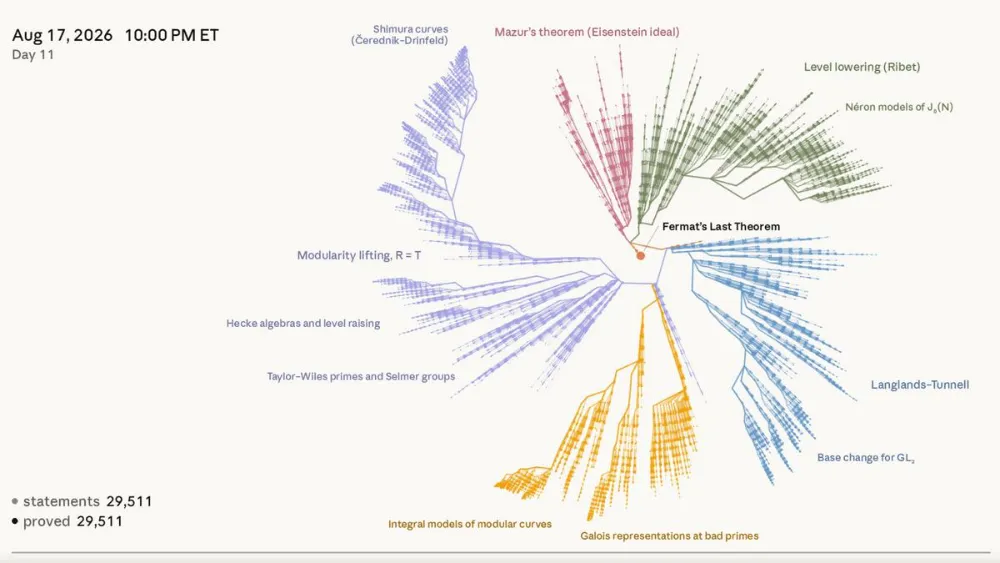
Claude在11天内完成费马大定理形式化证明的结构图,密集的分支代表相互依赖的中间数学定理。 | 图源:Anthropic
4天后,OpenAI扔出了一枚更重磅的炸弹:他们动用了约1万个AI智能体,连续运转88小时,生成了约1300亿个输出词元(token),宣称解决了困扰数学界近一个世纪的“千禧年大奖难题”之一——纳维-斯托克斯方程(Navier-Stokes equations)的存在性与光滑性问题。他们给出的答案是否定的:在特定光滑外力作用下,方程的光滑解会在有限时间内“爆破”(blow-up)。与之一同公布的,是一篇160多页的论文和配套的Lean代码。
突破接踵而至,让整个数学界猝不及防。这些由AI生成的证明往往长达数百页,信息密度极高,连顶尖的人类数学家读起来都如同天书。为了打消人类的疑虑,两家公司都把Lean形式化验证作为成果可靠性的重要依据。
这让一个原本属于数学和计算机科学交叉领域的小众工具,突然承担了巨大的责任。然而,当剑桥大学和伦敦国王学院的数学家细细查验时才发现,Lean的这张“保证书”,并不是完美无缺的。
Lean的诞生
数学以严格著称,但长期以来,数学知识的可靠性仍然依赖人与人之间的信任。
数学家在论文中使用的证明方式,通常建立在一套共同的知识和约定之上。作者可以引用前人已经证明的定理,可以省略同行熟悉的推导,也可以用一句“显然可得”,跨过一段在他们看来无需解释的逻辑过程。
这种习惯使数学论文能够在有限篇幅里表达极其复杂的思想。否则,哪怕证明一个相对简单的结论,都需要从最基础的数学公理开始,写下漫长的推导。
但人类认为显而易见的步骤,未必真的没有漏洞。
1998年,美国数学家托马斯·黑尔斯(Thomas Hales)宣布解决了著名的开普勒猜想。
这个问题可以追溯到17世纪。它试图回答,在三维空间中,怎样摆放大小相同的球体,才能让它们占据尽可能大的空间比例。
人们早就知道,水果摊上那种层层交错的橙子堆法十分紧密。开普勒猜想要证明的是,这种排列方式确实达到了理论上能够实现的最大密度。
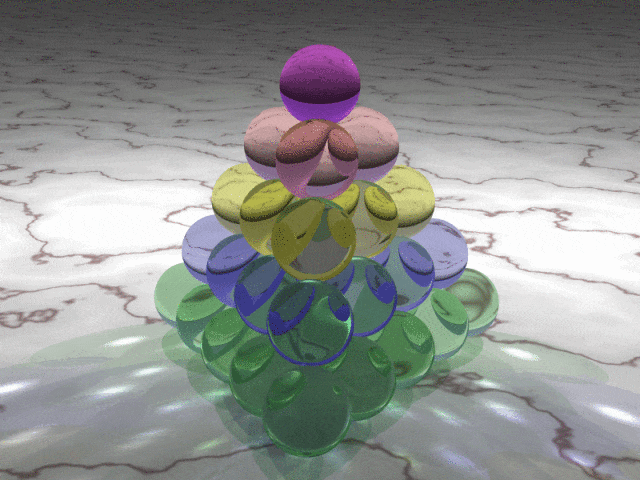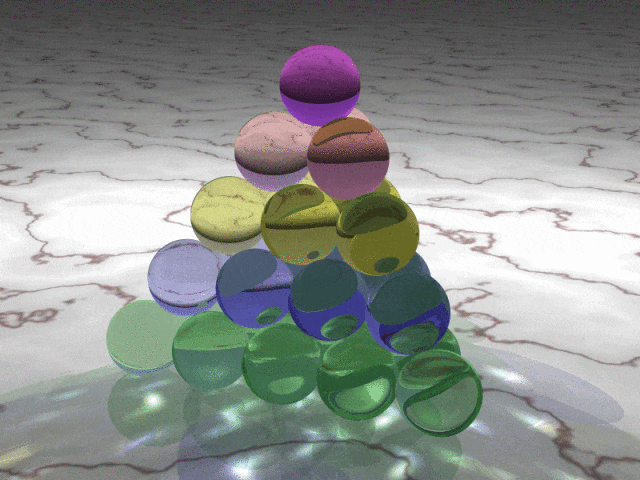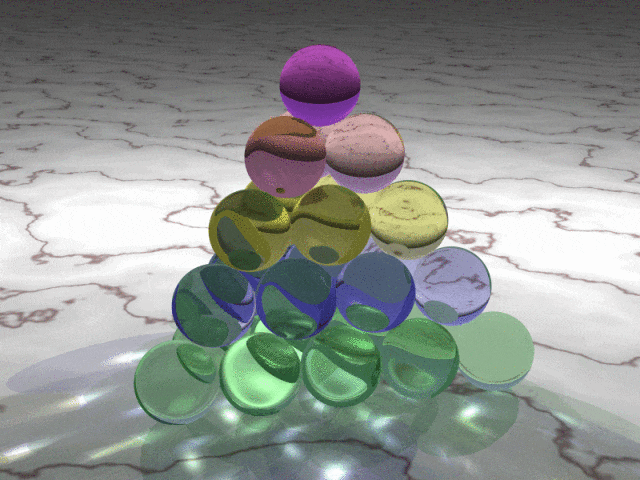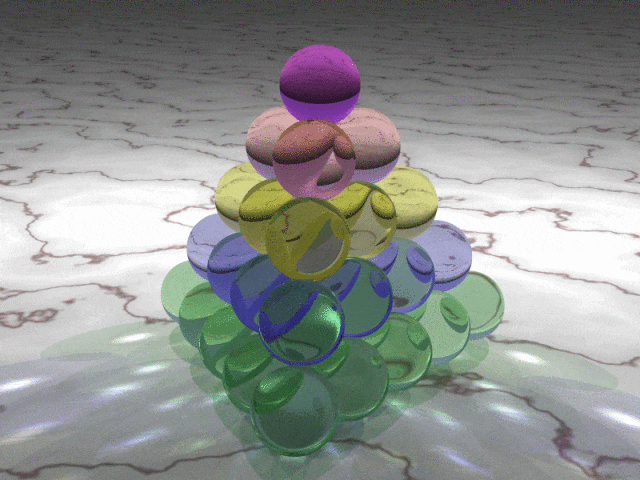
球体在三维空间中的紧密堆积方式,开普勒猜想认为这种排列可以达到最高约74%的空间填充密度 | 图源:Wikipedia
黑尔斯给出了证明,却遇到一个意想不到的困难。
他的论证包含大量复杂计算,需要借助计算机完成部分验证。负责审稿的数学家花费数年时间检查,仍然难以对全部细节建立充分信心,最终只表示“99%确定”证明是正确的。
2003年,黑尔斯启动了Flyspeck项目,希望让计算机承担这项工作。
但计算机并不理解传统数学论文。它无法像人类一样,看到一行公式就自动补全作者没有写出的步骤。研究人员必须把数学命题翻译成严格的形式化语言,将每一个定义、前提和推导关系准确表达出来。
这个过程被称为“形式化”(Formalization)。
2014年,研究团队最终用约50万行代码,完成了对开普勒猜想证明的形式化检验。
如此庞大的工程,也解释了为什么形式化证明迟迟无法在数学界大规模普及。
数学家需要一套足够严格的逻辑系统,还需要积累大量可以反复调用的数学定义与定理。更重要的是,他们必须亲手填补传统数学论文里那些被省略的步骤。
2013年,计算机科学家莱昂纳多·德莫拉(Leonardo de Moura)推出了Lean。
Lean是一种被称为“证明助手”(Proof Assistant)的软件。数学家可以用它编写定义、提出定理,并构建形式化证明。系统内部的检查程序负责判断,每一步推导是否符合既定的逻辑规则。
它与普通计算程序有一个根本区别。
普通程序运行成功,通常意味着计算机按照指令完成了某项操作。Lean中的证明通过检查,则意味着在给定的公理、定义和前提之下,目标命题能够通过合法的逻辑步骤推导出来。
为了实现这种严格性,Lean把最终检查集中在一个相对较小的逻辑核心中。外部程序可以帮助寻找证明、生成代码,最终的推导仍需经过核心检查。无论证明是人类还是AI写出的,都必须遵守同样的形式化逻辑规则。
Lean逐渐在数学界流行起来。2017年起,全球研究人员还共同建设了Mathlib数学库,将越来越多的数学知识转化为能够被计算机调用和验证的形式。
Lean形式化证明系统及其开源数学库Mathlib | 图源:Lean官方网站
但形式化始终是一件耗时的工作。过去,人类往往先完成数学证明,再选择一些重要成果进行形式化,以提高它们的可靠性。
大模型改变了这个顺序。随着AI越来越擅长编写代码,它开始能够自行完成大量形式化工作,并且在寻找证明的过程中,直接利用Lean判断推导能否成立。
一份人类需要数年整理的证明,如今可以在十几天里变成上千万行代码。Lean终于有机会实现数学家长期以来的愿望:让越来越多的数学知识获得机器验证。
可问题是,数学家原本希望使用Lean检查自己已经理解的证明,现在却反过来了。AI生成的证明规模越来越大、结构越来越复杂,人类反而需要依靠Lean,来判断自己尚未理解的内容是否可信。
随着这种变化,Lean的检查结果被赋予了一种超越技术的含义。
代码全部通过,却与论文对不上
今年9月,剑桥大学数学家安德斯·汉森(Anders Hansen)、法比安·奇尔切利(Fabian Circelli),以及伦敦国王学院数学家亚历山大·巴斯图尼斯(Alexander Bastounis),开始检查OpenAI公开的纳维–斯托克斯证明。
Lean可以确认形式化代码中的数学推导是否正确,但它检查的对象,始终是代码中实际写下的命题。当AI同时生成一篇供人类阅读的数学论文,以及一份供Lean检查的证明代码时,谁来保证两者说的是同一件事?
三位数学家用ChatGPT辅助比对OpenAI的自然语言论文和Lean代码,然后逐步检查可能存在差异的地方。
在持续约三个星期的研究中,他们对部分内容进行了深入核对。仅仅在详细检查的两页材料中,就发现了两处明确的数学差异。
其中一处出现在论文的第8.6号引理。
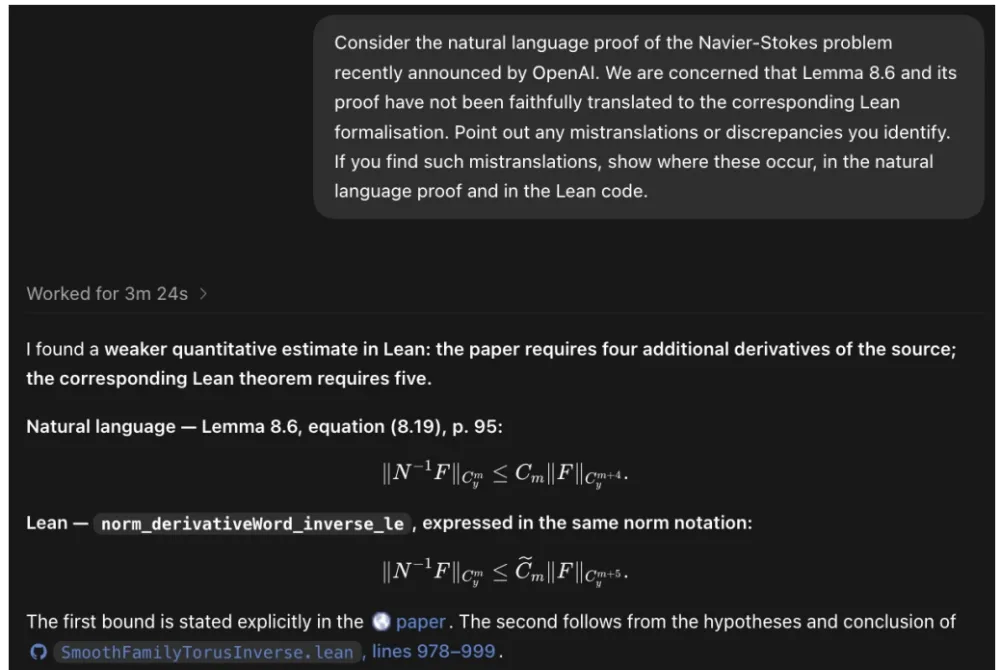
研究人员利用ChatGPT比对OpenAI的数学论文与Lean代码,发现同一项数学估计在两个版本中,分别需要控制原始函数直到m+4阶和m+5阶导数的大小。 | 图源:论文 Navier-Stokes Lost in Translation
这项引理涉及对一个微分算子“逆运算”结果的估计。所谓逆运算,就是反过来求解,已知求导之后的结果 F,找出原来的函数。引理要回答,解出来的函数有多光滑,取决于 F 有多光滑。
数学上常用"有多少阶连续导数"来衡量函数的光滑程度。这条引理给出的是一个定量估计,要控制解的前 m 阶导数(m 可以是任意非负整数),需要用到 F 的多少阶导数。
OpenAI 论文给出的答案是 m+4 阶,对应的 Lean 代码证明的却是 m+5 阶。
差这一阶,就是两个不同的数学命题。需要的导数阶数越高,前提就越苛刻,结论也就越弱。m+4 版本对 F 的光滑性要求较低就能给出控制,m+5 版本则把门槛抬高了一级。研究人员进一步发现,这与两个版本采用的傅里叶估计方法不同有关。
Lean最终证明的是一个适用条件更加严格、数学意义上更弱的结论。它履行了自己的职责。但是,当AI将数学论文转化为形式化代码时,原本需要证明的数学命题发生了变化,而机器检查只对代码里的命题负责,无从判断它是否符合论文原意。
这就像论文声称,一辆车只要有100马力就能爬上陡坡,而Lean验证的却是一辆150马力的车成功爬坡,两者或许都正确,但后者无法证明前者。
10月6日,三位数学家公布了题为《纳维–斯托克斯证明在翻译中迷失》(Navier-Stokes lost in translation)的预印本论文。
他们的研究并没有断言OpenAI的最终数学结论必然错误。纳维–斯托克斯问题涉及大量相互关联的数学推导,某个中间引理与形式化版本存在差异,并不足以单独推翻整个研究。
但这些差异足以说明,一份通过Lean检查的代码,无法自动为与它配套的自然语言论文提供完整的正确性保证。
假设一位数学家提出了一个命题,并写下一份证明。随后,他把命题交给AI,让AI寻找一份能够通过Lean检查的证明。
在这种情况下,AI完全可以抛开原来的推导,寻找新的数学方法。只要最终证明的仍然是同一个命题,这项工作就是成功的。
但如果数学家希望AI把原论文完整翻译成Lean代码,任务就完全不同了。
AI必须准确保留原文的定义、前提、命题和论证关系。即使原来的证明存在错误,也不能擅自修改条件或者替换结论,去验证一个不同的命题。
汉森等人在论文中给出了一个实验。他们向AI提供了一道关于多项式的数学问题,并故意在自然语言证明中,把两个根的重数写错。
AI生成的Lean代码最终通过了检查,因为AI自行修正了原始证明中的错误,给出了另一份正确的数学推导。
对于寻找正确证明的任务来说,这是值得肯定的能力。可如果任务是核查原始论文,AI的这种行为反而会掩盖问题。
这也解释了为什么自动形式化比一般的代码生成困难得多。
人类撰写的数学语言充满约定、缩写和隐含前提。有时,作者甚至没有意识到自己省略了某个重要条件。机器必须先确定原文究竟表达了什么,才能判断应该如何把它翻译成严格的数学命题。
因此,自动形式化面临两项不同的挑战:一项是让数学推导通过Lean检查,另一项是确保经过检查的数学内容,忠实地保留了原论文的含义。
AI正在快速解决前一项挑战,后一项则开始成为数学界新的难题。
当程序也能被欺骗
自然语言和形式化代码之间的差异,至少还保留着一道防线:只要有人愿意检查,仍然可以把两个版本逐项进行比较。
但今年7月发生的一件事,让数学家意识到,连负责验证逻辑的Lean程序本身,也存在出错的可能。
7月25日,研究人员拉马纳·库马尔(Ramana Kumar)在网上公开了一份利用AI辅助生成的Lean代码,声称推翻了著名的考拉兹猜想(Collatz Conjecture)。
这个猜想又被称为“3n+1猜想”,规则简单得令人难以置信。
从任意一个正整数开始,如果它是偶数,就除以2;如果是奇数,就乘以3再加1。对得到的新数字反复进行同样的操作。例如,从数字6出发,会依次得到3、10、5、16、8、4、2、1。考拉兹猜想认为,无论从哪个正整数开始,最终都会进入4、2、1的循环。
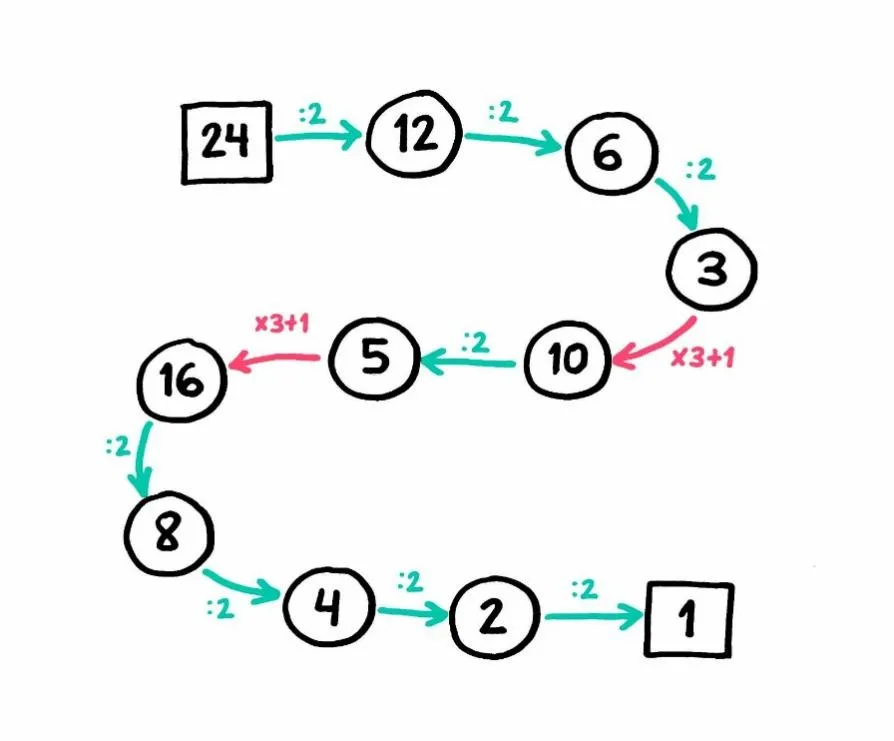
考拉兹猜想的数字轨迹 | 图源:La Vanguardia / Innovamat
几十年来,数学家已经检验了大量数字,却始终没有找到能够涵盖所有正整数的严格证明。
库马尔的代码声称证明了反例的存在,从而推翻了这个猜想。而且,它通过了Lean检查。
按照常规的形式化证明标准,这应当是一项令人震惊的数学发现。但三天后,研究人员基兰·戈皮纳坦(Kiran Gopinathan)发现了异常。
他将代码中的关键问题进一步简化,最终构造出一份能够让Lean接受“假”这一命题的证明,并向开发团队报告了漏洞。
在数学逻辑中,这意味着极其严重的问题。
一套正常的逻辑系统不应当同时接受一个命题及其否定。这相当于系统能够证明矛盾的命题,根据经典逻辑中的“爆炸原理”(Principle of Explosion),它可以推导出任意结论。
Lean团队很快找到了问题所在。
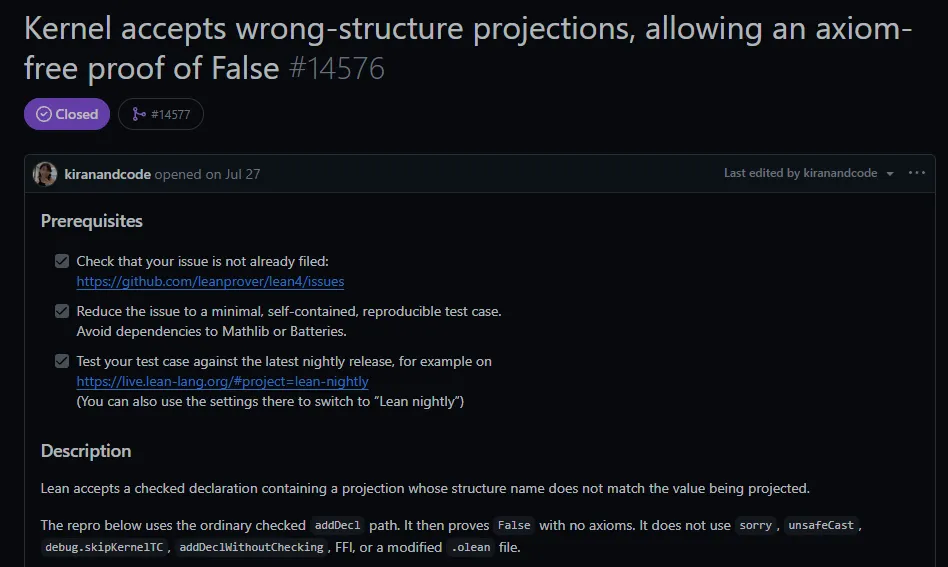
Lean官方漏洞报告 | 图源:GitHub
漏洞发生在Lean 4内核处理某类嵌套归纳类型的过程中。一些本应接受类型检查的参数,在内部处理时被遗漏了,使不符合规则的内容得以进入证明系统。
普通的Lean代码通常不会触发这个问题。但使用底层元编程接口构造特殊代码,就有机会绕过前端检查。
问题出在软件实现,而非数学逻辑本身。
Lean创建者德莫拉在8月1日发布了详细的事故报告。他特别强调,Lean的设计本来就不应当依赖外部工具或者代码生成器永远按照规则行事。
真正负责把关的逻辑内核,必须能够拒绝任何不符合规则的输入。
开发团队迅速修复了漏洞,并与OpenAI研究人员合作,利用更强的AI模型主动寻找其他问题。结果又发现了一系列能够破坏逻辑可靠性的程序缺陷。
其中一些漏洞涉及逻辑内核对类型的处理方式,另一些则发生在运行环境中。例如,AI发现可以利用对象引用计数溢出造成内存错误,进而构造出能够被接受的错误证明。
8月21日,Lean团队发布4.33.1版本,修复了这轮排查发现的问题。软件的可靠性,正成为数学可靠性的一部分。
当数学知识开始以机器速度增长
10月16日,巴扎德与另外6位数学家、形式化证明专家联合发表文章《如何形式化全部数学》(How to Formalize All of Mathematics),讨论如何利用AI,将人类积累的数学知识转化为机器能够验证的形式。
巴扎德认可Anthropic完成的1300万行Lean证明,但他仍然坚持自己的研究。因为数学知识的价值,还在于能否被后人理解、修改和利用。一份无人能够读懂的千万行证明,即使完全正确,也很难成为后来者继续探索的起点。
而对于陪伴Lean一路成长的老社区成员,这场变化还带着另一种失落。
Mathlib维护者安妮·巴嫩(Anne Baanen)记得,过去,来自世界各地的数学家聚集在网络聊天室里,为了一段复杂的证明反复推敲,逐行打磨代码。当困扰许久的难题终于解开,人们会共同分享那份发现的喜悦。
如今,科技巨头凭借庞大的算力,几天之内就能生成数百万行证明。曾经用来让数学更加严谨可靠的工具,也开始承载越来越多人类难以理解、甚至无法确认是否准确表达原意的AI成果。
“如果Lean的未来,是每一次互动都必须通过自动形式化来完成,”巴嫩说,“那么对我个人而言,那将是一个非常乏味的未来。”
这份失落背后,还有一个更加深刻的问题。
从19世纪末德国逻辑学家戈特洛布·弗雷格(Gottlob Frege)尝试用符号语言严格表达数学推理,到20世纪计算机证明助手的诞生,一代代数学家花费了近150年,希望让数学证明的每一步都经得起严格检验。如今,机器终于能够以前所未有的速度完成这些工作,人类却发现,仅仅获得一张“验证通过”的证书,仍然不足以回答所有问题。
当机器能够证明越来越多的定理,人类是否还能理解,它究竟证明了什么,又为什么成立?
参考资料
[1] https://www.science.org/doi/10.1126/science.aen6353
[2] https://xenaproject.wordpress.com/2026/09/04/flt-anthropic-has-beaten-me-to-it/
[3] https://www.anthropic.com/research/formalizing-fermats-last-theorem
[4] https://openai.com/index/navier-stokes-solution/
[5] https://arxiv.org/abs/2610.08144
[6] https://www.kcl.ac.uk/news/openais-navier-stokes-proof-called-into-question
[7] https://arxiv.org/abs/1501.02155
[8] https://lean-lang.org/
[9] https://mathlib.org/
[10] https://leodemoura.github.io/blog/2026-8-1-postmortem-for-kernel-soundness-bug-14576/
[11] https://leodemoura.github.io/blog/2026-8-24-postmortem-for-the-kernel-soundness-bug-hunt/
[12] https://xenaproject.wordpress.com/2026/10/16/how-to-formalize-all-of-mathematics/
[13] https://plato.stanford.edu/entries/frege-logic/
0
推荐

 京公网安备 11010502034662号